Poin Penting
- Kesiapan Ekstraksi GEO (Generative Engine Optimization): Algoritma modern dan metrik agentic browsing menuntut hierarki HTML yang bersih agar entitas bisnis Anda mudah diekstrak dan direkomendasikan oleh mesin pencari AI.
- Efisiensi Crawl Budget & Arsitektur: Standarisasi navigasi silo dan pembersihan rantai pengalihan (redirect chain) wajib dilakukan untuk memastikan bot perayap fokus pada halaman pilar tanpa hambatan error 404.
- Reduksi Code Bloat & Kinerja Rendering: Memangkas ukuran DOM (elemen bersarang) pada sistem page builder adalah keharusan teknis untuk mencapai skor Core Web Vitals (LCP, INP, CLS) yang optimal.
- Konsolidasi Otoritas & Search Intent: Implementasi Schema Markup (JSON-LD) yang presisi dipadukan dengan pembersihan keyword cannibalization akan secara objektif memusatkan otoritas pada halaman yang tepat.
Audit SEO on-page bukan sekadar modifikasi teks permukaan, melainkan evaluasi teknis menyeluruh terhadap arsitektur dan kode dasar situs. Pendekatan diagnostik berbasis data diperlukan untuk memastikan setiap elemen halaman dirender secara efisien dan dapat diakses tanpa hambatan, baik oleh crawler tradisional maupun model AI ekstraktif.
Mengapa Audit Arsitektur Web Kritis untuk Visibilitas AI & Mesin Pencari
Lanskap penelusuran telah bertransformasi dari sekadar pencocokan indeks menuju optimalisasi mesin generatif (Generative Engine Optimization atau GEO). Algoritma modern dan metrik agentic browsing mengekstraksi relasi data melalui hierarki HTML yang terstruktur secara semantik, bukan lagi sekadar membaca kepadatan kata kunci.
Sistem manajemen konten dan penggunaan page builder visual sering kali mengorbankan kebersihan kode dengan menghasilkan struktur DOM (Document Object Model) yang kompleks. Tanpa audit arsitektur yang objektif, redundansi kode ini akan memperlambat proses rendering, menurunkan skor pengujian kinerja, dan menghalangi bot untuk menguraikan konteks inti dari sebuah halaman web.
Evaluasi arsitektur web secara langsung menargetkan penyelesaian masalah teknis berikut:
-
Efisiensi Ekstraksi Data: Memastikan tag heading (H1, H2, H3) dan data terstruktur menyajikan hierarki informasi yang linier dan logis untuk diproses oleh Large Language Models (LLM).
-
Reduksi Beban Rendering: Memangkas code bloat atau elemen DOM yang tidak esensial untuk memfasilitasi waktu muat dan interaktivitas halaman yang optimal.
-
Penyelamatan Crawl Budget: Mengeliminasi jalur navigasi tertutup (dead ends) yang membuang alokasi waktu perayapan bot mesin pencari pada aset yang tidak krusial.
Arsitektur situs yang bersih dan efisien mendikte seberapa akurat mesin penelusur dapat memvalidasi, mengekstrak, dan merekomendasikan entitas bisnis Anda sebagai sumber yang otoritatif.
Evaluasi Hierarki Situs dan Crawlability
Fase audit SEO on-page website bisnis berikutnya berfokus pada aksesibilitas bot mesin pencari terhadap aset-aset situs yang kritis. Arsitektur informasi yang terfragmentasi memaksa crawler mengonsumsi lebih banyak waktu perayapan, menghabiskan crawl budget, dan berisiko membiarkan halaman penting gagal terindeks. Evaluasi diagnostik ini wajib menghasilkan peta jalan data yang transparan, baik untuk algoritma klasik maupun ekstraksi agentic browsing.
Standarisasi Struktur URL dan Navigasi Silo
Struktur URL harus mencerminkan hierarki informasi yang statis, ringkas, dan semantik. URL dinamis yang kerap kali di-generate secara default oleh sistem CMS sering memuat parameter atau ID yang tidak relevan, sehingga merusak kejelasan konteks.
Tindakan teknis yang harus dieksekusi:
-
Pemformatan Permalink Deskriptif: Konstruksi URL hanya dengan string teks berfokus kata kunci. Eliminasi variabel tanggal, ID angka, atau parameter string kompleks (misalnya: ubah
?p=123menjadi/layanan-seo/). -
Penerapan Arsitektur Silo: Kelompokkan halaman ke dalam direktori logis dan terpusat (contoh:
/layanan/web-development/ecommerce/). Pendekatan ini memperkuat sinyal otoritas topikal dan mempermudah bot dalam membangun knowledge graph terkait relasi antar halaman. -
Validasi Trailing Slash: Tetapkan aturan baku pada level server untuk konsistensi URL (memilih murni menggunakan garis miring di akhir atau tanpa garis miring) untuk mereduksi anomali konten duplikat.
Identifikasi Redirect Chain dan Resolusi Error 404
Manajemen pengalihan (redirection) yang buruk mendegradasi kinerja situs secara signifikan. Rantai pengalihan atau redirect chain (URL A > URL B > URL C) meluruhkan link equity di setiap lompatan dan menambah beban request HTTP. Sementara itu, akumulasi Error 404 (Not Found) menciptakan blind spot fatal yang mengganggu navigasi perayapan.
Fokus resolusi teknis meliputi:
-
Eliminasi Rantai Pengalihan: Identifikasi semua lonjakan redirect dan ratakan jalurnya secara langsung ke titik akhir (URL A > URL C). Pemangkasan ini akan langsung memperbaiki latensi akses.
-
Analisis 404 via Server Logs: Jangan hanya bergantung pada crawling tool standar. Audit log server untuk mendeteksi endpoint mana yang paling sering membentur status 4xx saat dikunjungi oleh Googlebot.
-
Implementasi 301 yang Semantik: Saat menangani halaman 404 yang memiliki metrik historis atau backlink, jangan arahkan ke beranda (homepage). Pasang 301 redirect menuju halaman yang secara spesifik memiliki kecocokan search intent terdekat
Diagnostik Kinerja Rendering & Core Web Vitals
Kecepatan situs kini diukur berdasarkan metrik interaktivitas dan stabilitas visual, bukan sekadar waktu muat total. Kinerja rendering yang buruk tidak hanya merugikan retensi pengguna, tetapi juga menghambat proses perayapan bot. Semakin lama server dan browser mengeksekusi aset situs, semakin rendah frekuensi indeksasi halaman.
Analisis Data PageSpeed Insights (LCP, INP, CLS)
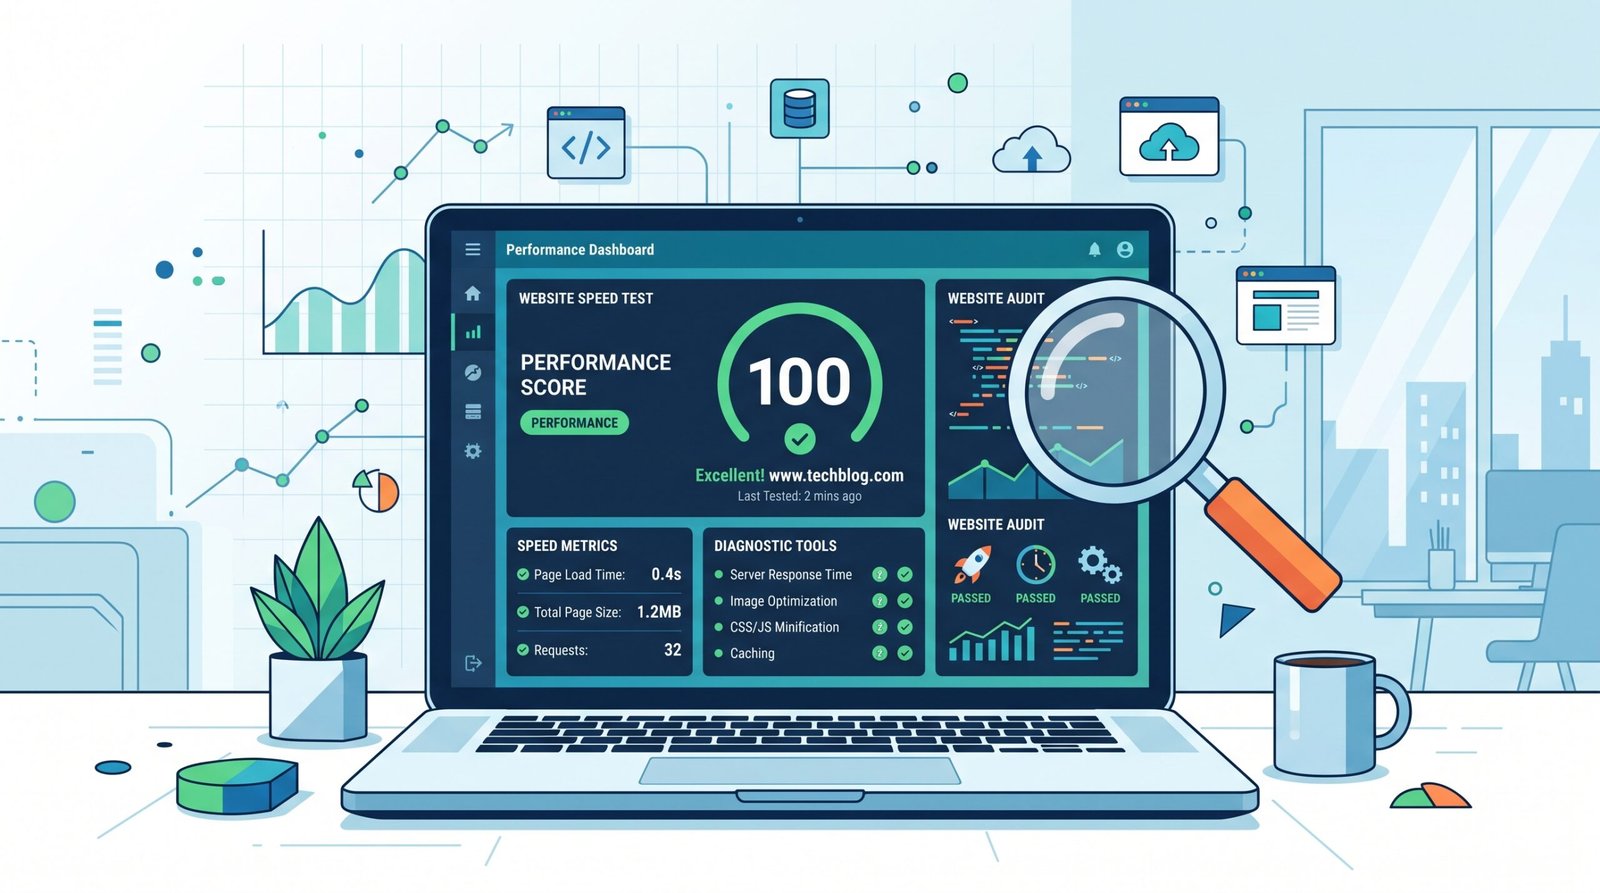
Penggunaan PageSpeed Insights (PSI) secara rutin adalah keharusan diagnostik untuk memantau metrik Core Web Vitals. Evaluasi ini berfokus pada data lapangan (field data) dan data lab untuk mengidentifikasi hambatan rendering pada critical rendering path.
Area perbaikan teknis meliputi:
-
LCP (Largest Contentful Paint): Targetkan waktu di bawah 2,5 detik. Optimalisasi dilakukan dengan melakukan preload pada hero image, mengimplementasikan format WebP/AVIF, dan menunda (defer) eksekusi JavaScript yang memblokir render di paruh atas (above the fold).
-
INP (Interaction to Next Paint): Targetkan latensi di bawah 200 milidetik. Resolusi berfokus pada pengurangan beban eksekusi thread utama. Hal ini menuntut minifikasi script, pemecahan long tasks, dan penundaan pemuatan skrip pihak ketiga.
-
CLS (Cumulative Layout Shift): Pertahankan skor di bawah 0,1. Cegah pergeseran layout dengan mendefinisikan atribut lebar (W) dan tinggi (H) eksplisit pada seluruh aset gambar serta kontainer iframe.
Reduksi DOM Size pada Sistem Page Builder
Pemanfaatan sistem manajemen konten seperti WordPress dengan page builder seperti Elementor sering kali menghasilkan penumpukan kode HTML (code bloat). Hierarki kontainer yang bersarang (nested div) secara berlebihan akan menciptakan ukuran Document Object Model (DOM) yang masif. DOM yang melampaui batas (di atas 1.500 nodes) akan memperburuk INP dan memperlambat ekstraksi data oleh agen AI.
Langkah mitigasi arsitektur meliputi:
-
Transisi ke Flexbox atau Grid Container: Tinggalkan struktur kolom atau section tradisional yang berbasis tumpukan div. Penggunaan Flexbox container memangkas kedalaman node secara signifikan dan merampingkan output HTML.
-
Eliminasi Widget Redundan: Audit dan nonaktifkan fitur atau widget bawaan yang tidak terpakai. Hindari penggunaan elemen visual berat yang memanggil skrip eksternal ganda jika fungsinya bisa diselesaikan melalui CSS kustom.
-
Optimalisasi Conditional Loading: Pastikan file CSS dan JavaScript hanya dimuat pada halaman yang benar-benar membutuhkan aset tersebut, bukan dimuat secara global (site-wide) yang membebani memori peramban.
Optimalisasi Ekstraksi Data melalui Tag HTML & Skema
Bagi mesin pencari tradisional maupun model Generative Engine Optimization (GEO), memproses halaman web adalah proses ekstraksi entitas. Konten teks yang padat tanpa markup semantik akan gagal diterjemahkan ke dalam knowledge graph. Oleh karena itu, tag HTML dan data terstruktur harus dikonfigurasi sebagai API internal halaman yang menyuapi data secara sistematis kepada crawler.
Validasi Struktur H1-H3 dan Keyword Placement
Hierarki heading (H1-H6) bukan sekadar variabel ukuran font atau estetika desain, melainkan peta relasi relasional konten. Sistem AI memproses tag ini untuk mengonstruksi pemahaman tentang topik utama (H1) dan sub-topik pendukungnya (H2 dan H3). Anomali urutan HTML (seperti melompat dari H1 langsung ke H3) akan mendisrupsi alur logika ekstraksi mesin.
Tindakan validasi teknis meliputi:
-
Isolasi H1 Mutlak: Batasi penggunaan tag H1 hanya satu kali per halaman, terletak di bagian paling atas Document Object Model (DOM). H1 wajib merepresentasikan search intent inti secara spesifik dan menyertakan kata kunci target (seperti “Cara audit SEO on-page website bisnis”).
-
Sarang Logis (Logical Nesting): Pastikan H2 bertindak sebagai pilar argumen utama, sementara H3 menguraikan detail teknis di bawah H2. Eksekusi ini meniru struktur blueprint yang mudah disekat dan diindeks secara parsial oleh bot.
-
Penempatan Keyword Berbasis Prominence: Injeksi kata kunci dan entitas terkait pada 100 kata pertama, atribut
altpada gambar strategis, serta di dalam tag anchor text internal. Hindari keyword stuffing; fokuskan pada kedekatan leksikal (LSI).
Implementasi Schema Markup (Data Terstruktur)
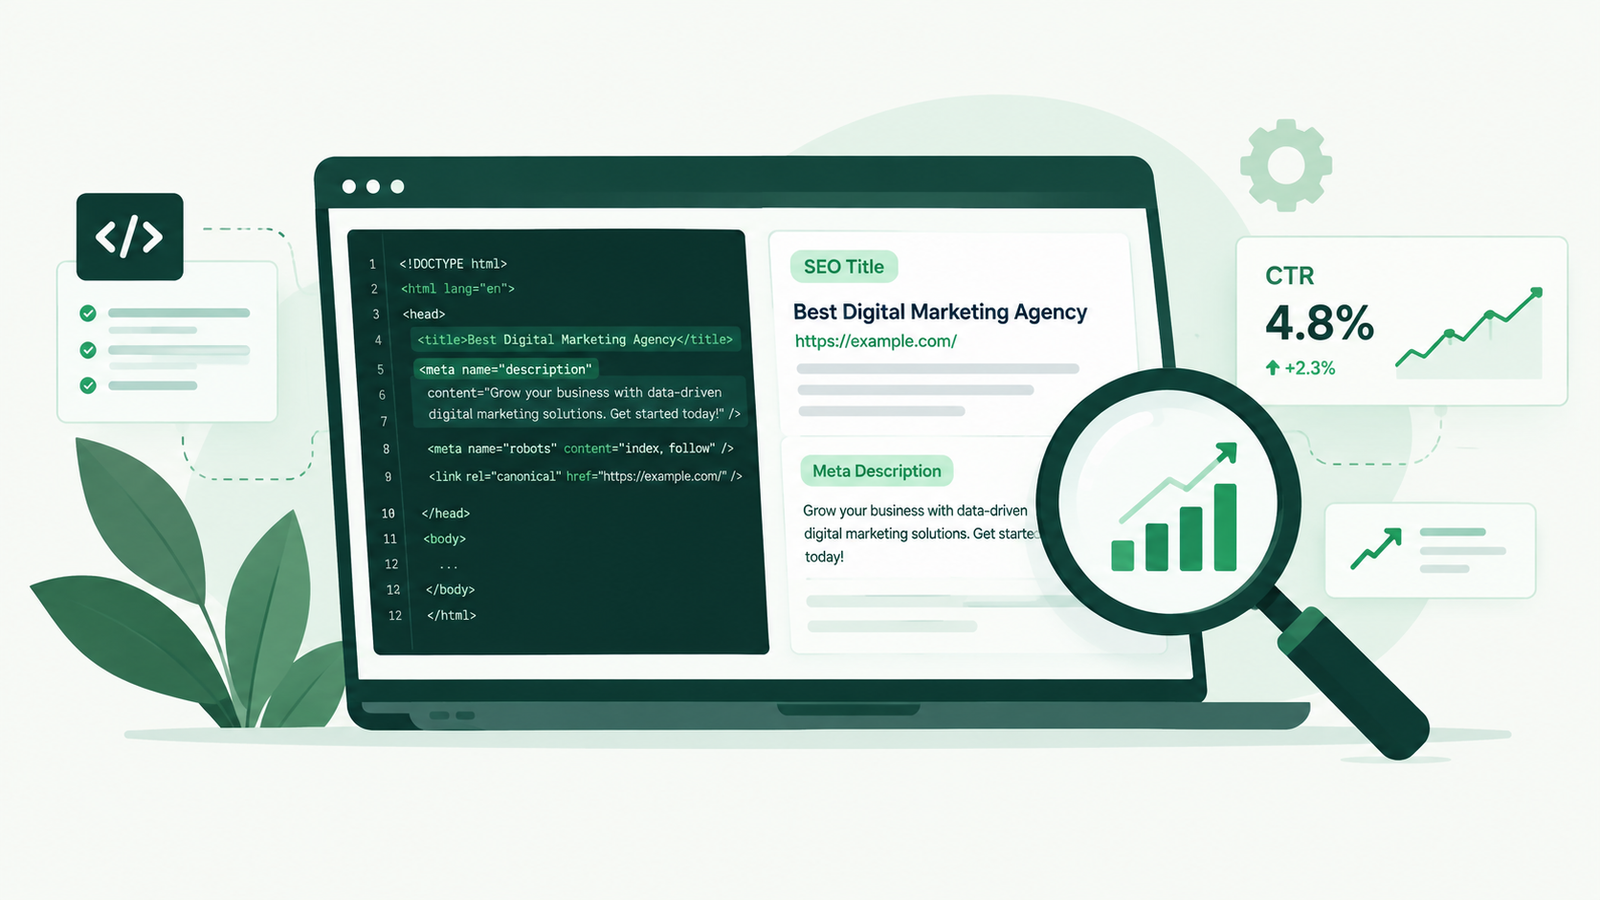
Schema markup adalah lapisan kode yang membypass kebutuhan mesin pencari untuk “menebak” makna konten. Dengan mendefinisikan elemen secara spesifik melalui standar Schema.org, halaman memiliki peluang mutlak untuk mendominasi Rich Snippets dan dirujuk langsung oleh asisten AI.
Standar implementasi teknis yang diwajibkan:
-
Format JSON-LD: Tinggalkan implementasi Microdata berbasis HTML lama. Injeksi script JSON-LD langsung ke bagian
<head>untuk mempercepat parsing data tanpa menambah kompleksitas elemen visual. -
Akurasi Tipe Entitas: Petakan skema sesuai arsitektur layanan. Terapkan
OrganizationatauLocalBusinessdi beranda,Serviceuntuk halaman produk, sertaFAQPagedanArticleuntuk bagian edukasi. -
Validasi Zero-Error: Eksekusi pengujian ketat sebelum publikasi menggunakan Google Rich Results Test dan Schema Markup Validator. Kegagalan parsing satu baris JSON akibat kesalahan koma (,) dapat membatalkan seluruh integrasi data terstruktur.
Pembersihan Konten dan Resolusi Keyword Cannibalization
Audit arsitektur situs tidak hanya tentang membenahi kode, tetapi juga mengeleminasi anomali struktural pada level konten. Keyword cannibalization terjadi ketika dua atau lebih halaman di dalam satu domain bersaing untuk kata kunci target yang sama. Redundansi ini mendilusi link equity, membingungkan algoritma mesin pencari dalam menentukan halaman kanonikal, dan secara langsung mendegradasi posisi peringkat di SERP (Search Engine Results Page).
Pencocokan Search Intent Berbasis Data
Resolusi kanibalisasi tidak boleh didasarkan pada asumsi, melainkan wajib diukur melalui data metrik performa. Diagnostik harus membedah apakah halaman yang saling bersinggungan memiliki search intent yang identik (misalnya sama-sama informasional) atau berbeda.
Metodologi audit yang harus dieksekusi:
-
Pemetaan Kueri via Google Search Console (GSC): Ekspor data Performance dan identifikasi kueri tunggal yang memicu impresi untuk beberapa URL (URL overlap).
-
Analisis Ketidaksesuaian Intent (Intent Mismatch): Evaluasi SERP secara aktual. Jika mesin pencari meminta halaman transaksional (layanan/produk) namun URL Anda yang merespons adalah artikel blog informasional, Anda harus melakukan kalibrasi ulang struktur internal.
-
Segmentasi Topikal: Pastikan setiap URL memiliki target primer yang eksklusif. Gunakan variasi LSI (Latent Semantic Indexing) secara ketat untuk membedakan konteks halaman satu dengan yang lainnya.
Konsolidasi Halaman dan Eliminasi Konten Duplikat
Setelah data anomali terpetakan, eksekusi teknis harus dilakukan untuk membersihkan situs dari konten tipis (thin content) atau duplikasi informasi. Langkah ini akan merampingkan arsitektur situs dan memusatkan otoritas (page authority) pada halaman-halaman pilar (URL inti).
Langkah resolusi teknis meliputi:
-
Konsolidasi Melalui 301 Redirect: Jika terdapat dua artikel dengan topik yang identik, gabungkan konten dari halaman yang lebih lemah ke halaman yang memiliki profil backlink dan traffic tertinggi. Pasang 301 redirect dari URL lama menuju URL utama.
-
Implementasi Tag Canonical (
rel="canonical"): Untuk duplikasi yang tidak bisa dihindari (seperti parameter filter produk pada e-commerce atau arsip kategori), injeksi tag canonical yang secara eksplisit menunjuk ke URL master untuk mencegah indeksasi ganda. -
Audit Pemangkasan (Content Pruning): Hapus halaman usang atau usang secara permanen dengan memberikan kode status HTTP 410 (Gone). Ini memberi sinyal tegas kepada bot untuk menghapus URL tersebut dari indeks secepatnya guna menghemat crawl budget.