Poin Penting
- Kepemilikan Data Penuh: Ekosistem WordPress memberikan kontrol 100% atas aset digital dan data pelanggan tanpa biaya langganan platform bulanan.
- Kecepatan Menentukan Konversi: Penundaan loading 1 detik dapat memangkas konversi hingga 7%; optimasi Core Web Vitals adalah keharusan teknis.
- Desain Berbasis CRO: UI/UX toko online harus dirancang secara terstruktur untuk memandu alur checkout tanpa friksi, terutama bagi pengguna mobile.
- Kesiapan AI dan GEO: Implementasi Schema Markup produk yang presisi memastikan toko online Anda siap dipahami dan direkomendasikan oleh mesin pencari AI.
Peningkatan traffic organik melalui restrukturisasi kategori mensyaratkan eksekusi teknis yang presisi dan berbasis data. Perombakan taksonomi bukan sekadar perbaikan navigasi antarmuka, melainkan penyelarasan arsitektur informasi. Tujuannya adalah mengoptimalkan alur perayapan (crawl path) dan resolusi entitas (entity resolution), baik untuk search engine tradisional maupun metrik ekstraksi LLM pada Agentic Browsing.
1. Diagnostik Arsitektur Web dan Fragmentasi Data
Fase awal restrukturisasi berfokus pada identifikasi bottleneck struktural. Arsitektur web yang tumbuh tanpa kontrol sering kali memicu fragmentasi data. Kondisi ini menyebabkan bobot relevansi (topical authority) terpecah ke berbagai halaman dengan muatan (payload) yang tumpang tindih.
Audit Taksonomi dan Deteksi Kanibalisasi Kategori
Audit taksonomi dilakukan untuk mendeteksi anomali struktural di mana dua atau lebih kategori berkompetisi untuk kueri pencarian yang sama. Kategori yang tidak terisolasi secara semantik akan merusak sinyal relevansi.
Proses diagnostik mencakup:
-
Ekstraksi Arsitektur URL: Menggunakan crawler teknis (seperti Screaming Frog atau Sitebulb) untuk memetakan seluruh hierarki direktori aktif.
-
Pemetaan Search Intent: Menganalisis korelasi antara query target dan halaman kategori guna mendeteksi intent yang berbenturan (kanibalisasi).
-
Identifikasi Duplikasi Topikal: Menemukan variasi kategori atau sistem tagging berbeda yang menyajikan kompilasi konten identik.
Evaluasi Efisiensi Crawl Budget pada Struktur Lama
Struktur hierarki yang terlalu dalam (deep architecture) atau implementasi taksonomi ganda (seperti penggunaan tag dan category secara bersamaan tanpa aturan kanonikal) akan mendisipasi crawl budget. Bot perayap mengalokasikan sumber daya komputasi pada URL bernilai rendah (low-value URLs), sehingga menghambat penemuan halaman utama.
Evaluasi teknis dilakukan melalui:
-
Analisis Log Server (Log File Analysis): Memeriksa hit rate bot perayap pada direktori kategori untuk mengisolasi area crawl trap atau infinite spaces.
-
Pengukuran Kedalaman Klik (Crawl Depth): Mengaudit jarak klik dari homepage. Kategori utama dan sub-kategori idealnya dapat diakses maksimal dalam 3 klik (Level 3).
-
Audit Kualitas Payload Halaman: Mendata URL kategori yang tergolong thin content, menghasilkan status HTTP 404, atau terperangkap dalam redirect chains.
2. Metodologi Restrukturisasi Berdasarkan Tipe Payload
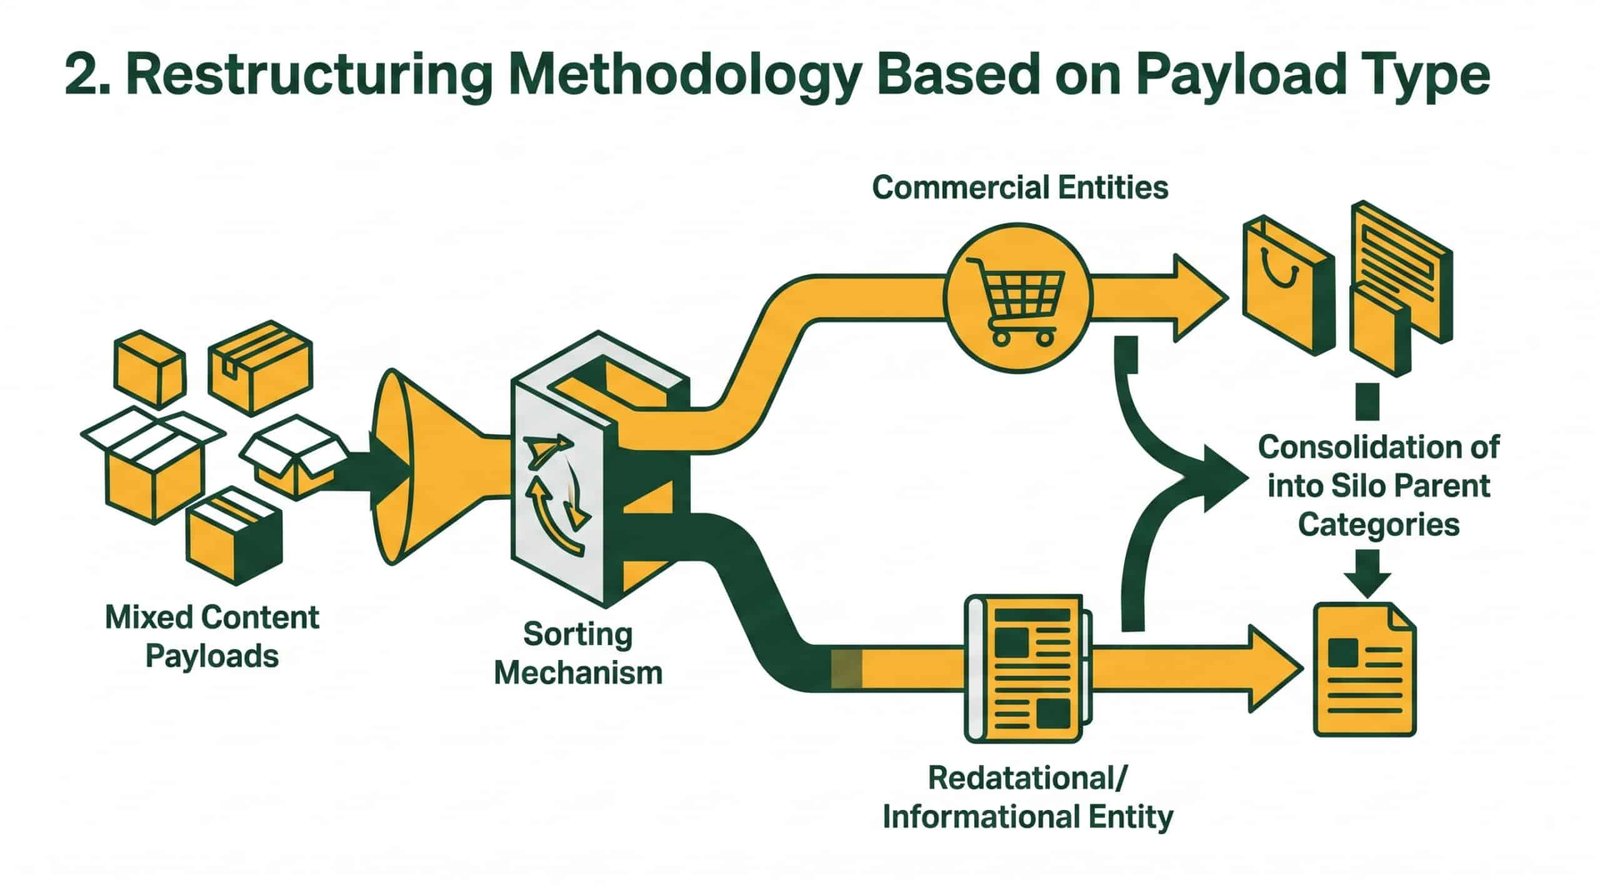
Restrukturisasi arsitektur web tingkat lanjut mengandalkan kategorisasi berbasis tipe payload atau muatan dokumen. Pendekatan ini mengklasifikasikan halaman berdasarkan fungsi intrinsiknya. Hal ini memastikan crawler pencari dan model bahasa generatif (LLM) dapat memisahkan konteks dokumen secara presisi.
Pemisahan Entity Komersial vs. Redaksional (Informational)
Mencampur halaman berorientasi transaksional dengan konten edukasional dalam satu rantai direktori akan mendistorsi search intent. Pemisahan entity mutlak diperlukan untuk membangun silo topik yang murni secara semantik.
Langkah eksekusi pemisahan meliputi:
-
Isolasi Direktori Komersial: Mengunci halaman layanan atau produk pada struktur URL hierarki atas yang statis (contoh:
/layanan/audit-teknis/). -
Segmentasi Sub-folder Redaksional: Mengelompokkan artikel panduan, dokumentasi, atau studi kasus ke dalam sub-folder terpisah (contoh:
/panduan/seo-teknis/). -
Interlinking Kontekstual yang Terkontrol: Menghubungkan entitas redaksional ke entitas komersial melalui tautan internal (internal link) asimetris. Tujuannya adalah mengalirkan PageRank ke halaman komersial tanpa mengaburkan arsitektur direktori.
Konsolidasi Halaman Thin Content ke Kategori Induk (Siloing)
Halaman kategori dengan jumlah arsip minimum atau duplikasi deskripsi (thin content) secara sistematis menurunkan metrik kualitas domain (sitewide quality). Konsolidasi taksonomi melalui metode siloing bertujuan untuk memusatkan link equity pada halaman pilar yang terbukti memiliki otoritas lebih tinggi.
Tindakan teknikal dalam fase ini mencakup:
-
Penggabungan Sub-kategori Rentan: Mentransfer payload dari sub-kategori sekunder yang tidak memiliki daya saing kueri ke dalam kategori induk (parent category) yang lebih komprehensif.
-
Penerapan Filter Faset (Faceted Navigation): Mengganti arsitektur sub-kategori statis dengan parameter filter dinamis. Akses bot crawler pada URL parameter dikontrol ketat menggunakan aturan
Disallowdi robots.txt dan tagrel="canonical"yang mengarah ke kategori utama. -
Pruning Direktori Kosong: Memangkas kategori yang sudah tidak memiliki muatan aktif menggunakan status code HTTP 410 (Gone) guna mempercepat proses de-indeksasi oleh mesin pencari.
3. Eksekusi Teknis: Retensi Otoritas Selama Migrasi
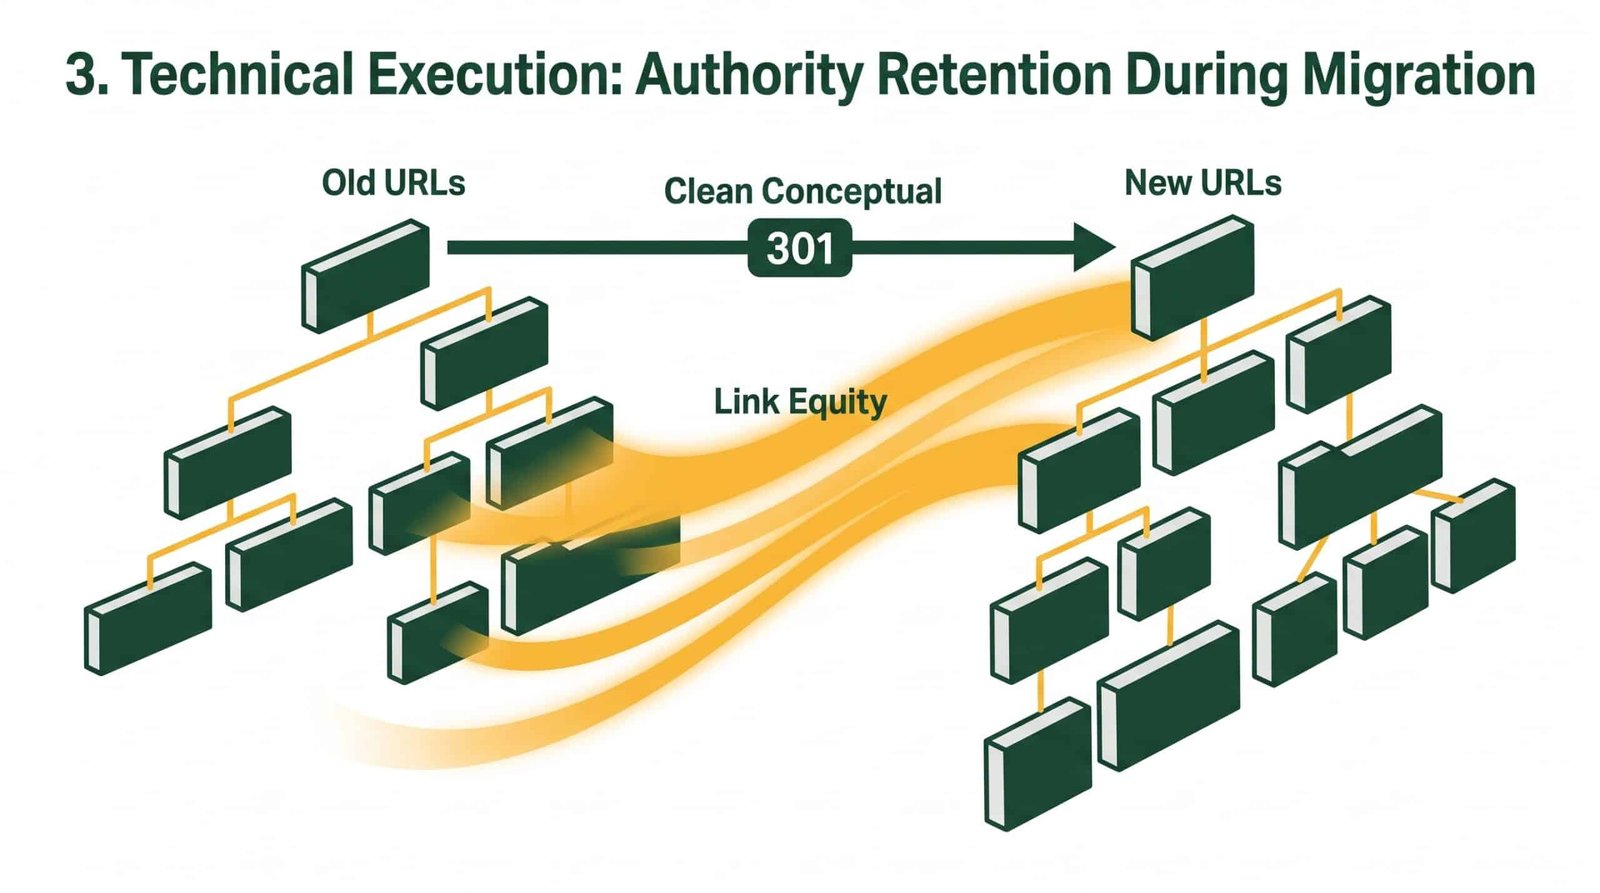
Perubahan URL kategori membawa risiko devaluasi sinyal otoritas secara sistematis. Eksekusi teknis pada fase migrasi harus dikontrol secara ketat untuk memastikan transfer link equity (PageRank) dari arsitektur lama ke taksonomi baru berjalan presisi tanpa interupsi perayapan.
Pemetaan Skema Redirect 301 Tanpa Kehilangan Link Equity
Protokol pengalihan permanen (HTTP 301) adalah instrumen utama untuk merestrukturisasi rute crawler. Pemetaan yang tidak akurat akan memicu status soft 404 dan mendisrupsi upaya peningkatan traffic organik.
Prosedur teknikal pemetaan redirect mencakup:
-
Mapping 1-to-1 Secara Semantik: Mencocokkan URL kategori lama dengan URL kategori baru yang memiliki relevansi payload paling identik. Hindari pengalihan massal (blanket redirect) ke homepage.
-
Implementasi RegEx (Regular Expressions) Tingkat Server: Mengeksekusi pengalihan pada level server (konfigurasi Nginx atau Apache) untuk memproses perubahan string atau struktur folder tanpa membebani pemrosesan aplikasi.
-
Pembaruan Tautan Internal (Hardcoding): Mengeksekusi perintah SQL (Search and Replace) pada basis data untuk memperbarui tautan internal absolut, sehingga lalu lintas tidak perlu melewati rute 301 terlebih dahulu.
Mitigasi Risiko Orphan Pages dan Redirect Chains
Restrukturisasi arsitektur taksonomi rentan menghasilkan orphan pages (halaman tanpa tautan masuk internal) dan redirect chains (rantai pengalihan ganda). Kedua anomali ini mendegradasi efisiensi crawl budget dan memicu latensi transfer otoritas.
Langkah mitigasi operasional meliputi:
-
Resolusi Rantai Pengalihan: Menggunakan perangkat lunak crawling untuk mengidentifikasi siklus pengalihan (A -> B -> C). Konfigurasi harus diratakan menjadi satu lompatan absolut (A -> C).
-
Integrasi Entitas yang Terputus: Mengaudit daftar URL lama yang terdeks indeks namun kehilangan rute navigasi pada struktur baru (orphan pages), lalu menyuntikkan tautan kontekstual dari kategori pilar terdekat.
-
Strategi Peta Situs (XML Sitemap) Transisional: Mengirimkan (submit) peta situs yang berisi URL lama ke Google Search Console secara bersamaan dengan peta situs struktur baru. Taktik ini mempercepat penemuan status 301 oleh bot crawler.
4. Optimasi Taksonomi untuk Agentic Browsing (GEO)
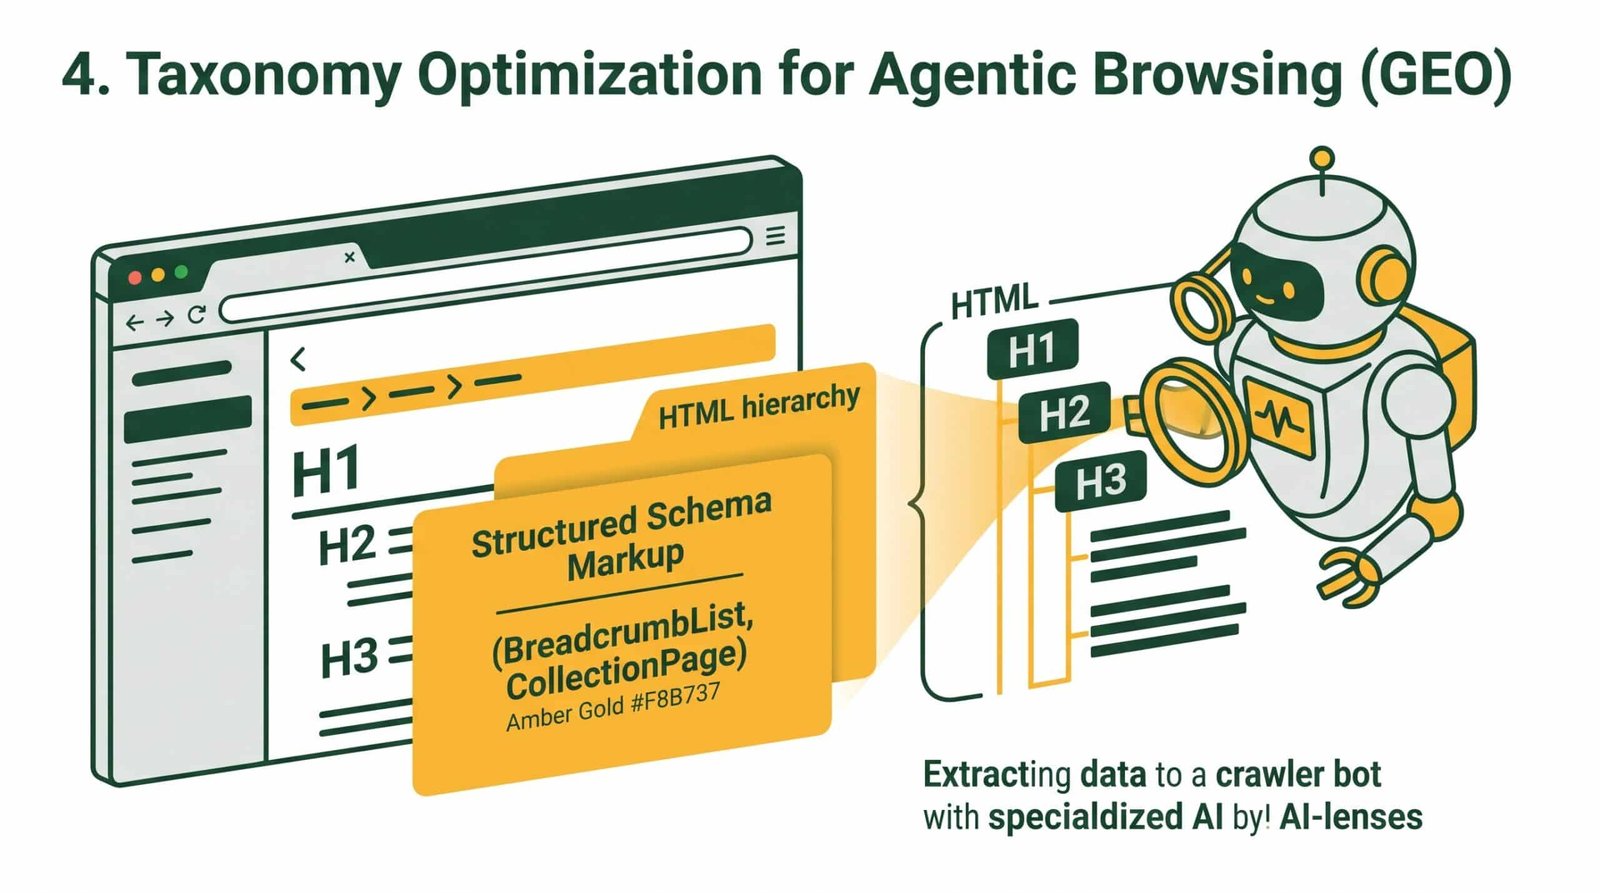
Generative Engine Optimization (GEO) menuntut arsitektur data yang dapat diproses secara deterministik oleh model bahasa besar (LLM). Agen AI dan bot crawler modern tidak sekadar membaca teks, melainkan mengekstraksi entitas melalui pemodelan relasional. Restrukturisasi kategori harus memfasilitasi ekstraksi ini melalui standardisasi kode dan markup terstruktur.
Standarisasi Hierarki HTML untuk Ekstraksi LLM
Pohon DOM (DOM tree) yang bersih dan terstruktur secara semantik mempercepat resolusi entitas oleh algoritma AI. Hierarki tag HTML berfungsi sebagai peta bobot informasi (information weighting) yang mengarahkan LLM pada payload utama kategori.
Standardisasi dieksekusi melalui:
-
Implementasi Tag Semantik Absolut: Menggunakan tag
<main>,<section>, dan<nav>untuk mengisolasi navigasi dari konten inti. Hal ini mencegah LLM mencampuradukkan menu sidebar dengan payload halaman. -
Hierarki Heading Linear (H1-H6): Memastikan tidak ada heading yang terlewati (skipped heading levels). H1 dikhususkan untuk entitas kategori, H2 untuk sub-topik atau segmen listing, dan H3 untuk item spesifik.
-
Reduksi Kedalaman DOM (DOM Depth): Meminimalkan nested div yang tidak esensial untuk mempercepat proses rendering (Rendering Critical Path) oleh mesin perayap berbasis Chromium (WRS).
Injeksi Schema Markup (Breadcrumb & CollectionPage) pada Kategori Baru
Schema markup bertindak sebagai API pasif yang menyuapkan struktur data langsung ke mesin pencari. Untuk halaman kategori, penggunaan skema spesifik memvalidasi hubungan antar-direktori secara eksplisit.
Spesifikasi teknis injeksi markup (berbasis JSON-LD) meliputi:
-
Skema
BreadcrumbList: Mendefinisikan posisi absolut kategori dalam hierarki web. Setiap node (Item) harus memuat nama kategori dan URL absolut untuk membangun sitelinks yang akurat di SERP. -
Skema
CollectionPagedanItemList: Mendeklarasikan halaman sebagai agregator entitas. Penggunaan propertihasPartatauitemListElementmembantu agen pencari memahami bahwa URL tersebut membawahi kumpulan dokumen atau produk spesifik. -
Validasi Real-time: Menggunakan API pengujian Rich Results untuk memverifikasi bahwa sintaks JSON-LD bebas dari fatal error yang dapat menggagalkan ekstraksi data.
5. Evaluasi Pasca-Implementasi (Post-Deployment)
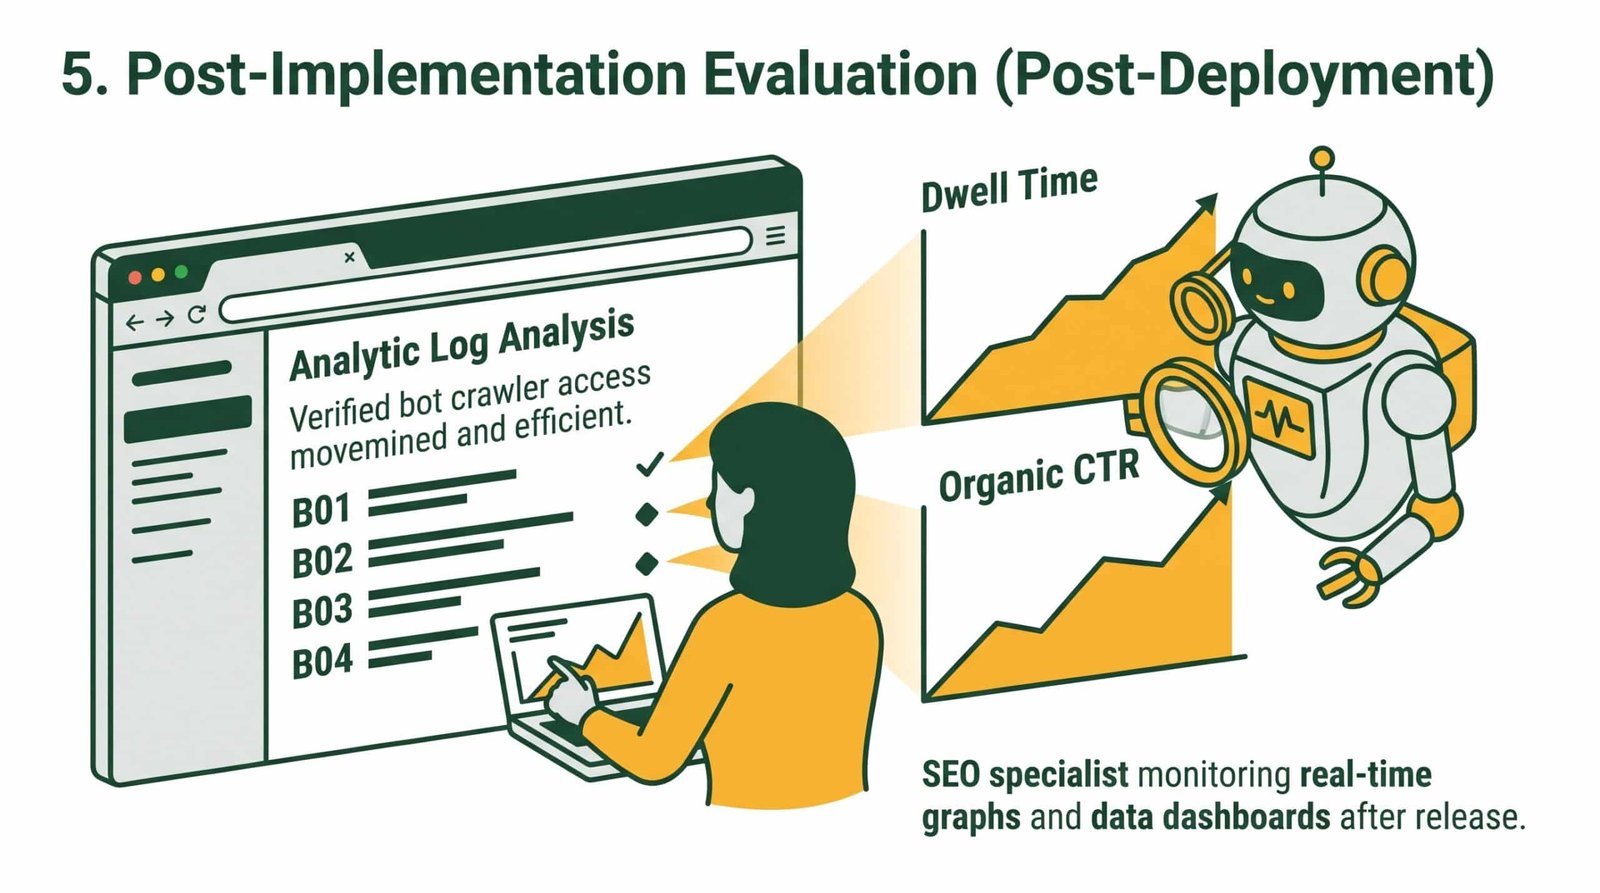
Fase post-deployment mengandalkan telemetri data untuk memvalidasi keberhasilan arsitektur baru. Peningkatan traffic organik melalui restrukturisasi kategori hanya dapat dikonfirmasi melalui analisis respons server dan metrik interaksi user.
Analisis Log Server untuk Verifikasi Akses Bot Crawler
Data analitik pihak ketiga (seperti Google Analytics) tidak dapat merekam aktivitas perayapan bot. Analisis log server (Log File Analysis) memberikan visibilitas mentah terhadap interaksi crawler dengan struktur baru.
Parameter diagnostik mencakup:
-
Distribusi Kode Status HTTP: Memantau lonjakan hit pada status 301 untuk memastikan bot mentransisi indeks, serta mendeteksi anomali lonjakan 404 pada URL lama.
-
Frekuensi Perayapan (Crawl Frequency): Memvalidasi apakah Googlebot dan Bingbot mengalokasikan crawl budget yang lebih tinggi pada kategori pilar (silo) yang baru dibangun.
-
Log User-Agent AI: Memantau jejak akses dari perayap spesifik AI (seperti ChatGPT-User atau ClaudeBot) ke dalam struktur kategori baru.
Pemantauan Metrik Interaksi (Dwell Time & CTR Organik)
Relevansi struktural yang diperbaiki harus berkorelasi langsung dengan peningkatan metrik kepuasan pengguna (user intent satisfaction). Pemantauan difokuskan pada metrik perilaku yang menjadi sinyal kualitas bagi algoritma pencari.
Metrik evaluasi utama meliputi:
-
Varian Click-Through Rate (CTR) di GSC: Menganalisis kurva CTR pada kueri kategori utama. Arsitektur yang bebas dari kanibalisasi idealnya menghasilkan CTR yang terkonsolidasi pada satu URL pilar.
-
Engagement Rate dan Dwell Time (GA4): Mengukur durasi sesi aktif pada halaman kategori baru. Peningkatan dwell time mengindikasikan bahwa sistem siloing berhasil mempertahankan navigasi pengguna di dalam kluster topik yang relevan.
-
Analisis Query Yield: Mengukur ekspansi jumlah long-tail keywords baru yang berhasil diindeks per halaman kategori pasca-restrukturisasi.